


컴퓨터 오라클 SQL에서 정규분포식 구현 2 - 누적확률 함수 (무식한 방법)
2015.07.19 18:22
들어가기 전에 – 여기서 쓰인 SQL 은 쓸 만한 게 못된다. 그냥 이렇게 저렇게 삽질한 시행착오의 과정을 보면서 배워보자는 거지, 쓰라고 하는 거 아니다. 실용적인 건 다음, 다음 글에 나온다.
다시 한 번 말한다. 바로 쓸 SQL을 원한다면, Back 하자.
앞의 정규분포 확률밀도 함수를 구하는 건 간단하게 되었는데, 정규분포 함수를 만드는 건 왜 쉽지 않냐라고 하면, 실제로는 저거 외에 누적 정규분포 확률 함수를 구현해야 한다는 거다.
앞의 글에서 본 그래프를 먼저 보자.
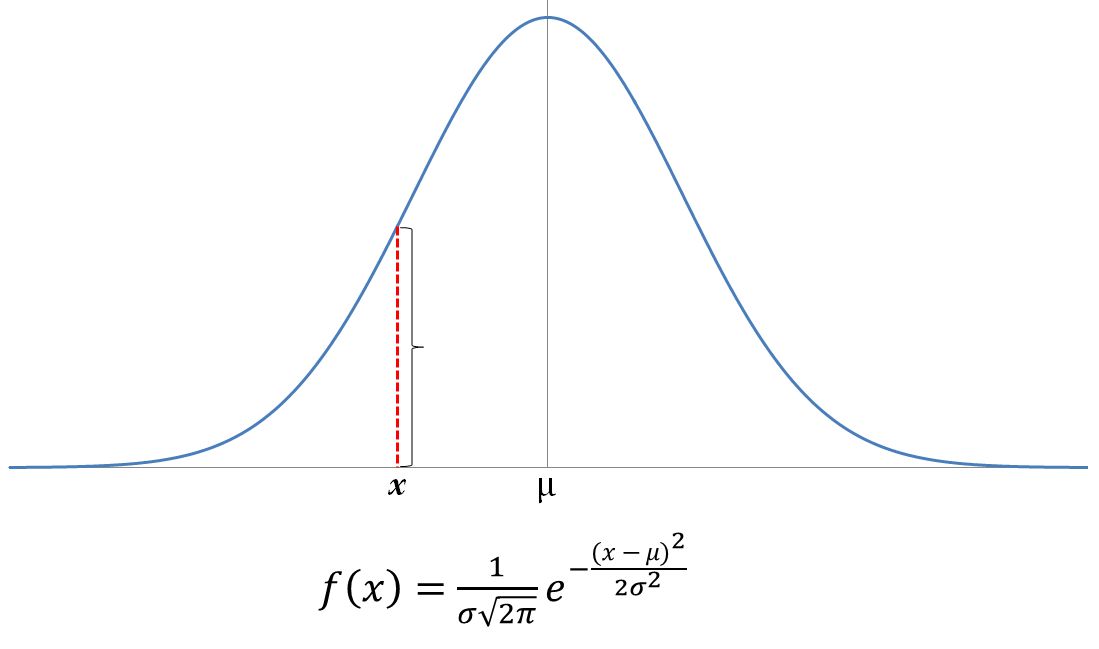
이건 확률 밀도 함수(라고 한다. 설명 못한다)이며 구하는 것은 저 높이 하나만 구하는 거다. 하지만 저거 말고 진짜 구해야 하는 건 바로 마이너스 무한대에서부터 x 까지의 넓이를 구해야 한다는 거.
넓이? 내가 수학에서 싫어하기로 손꼽히는 분야 적분이 들어가야 한다는 거.
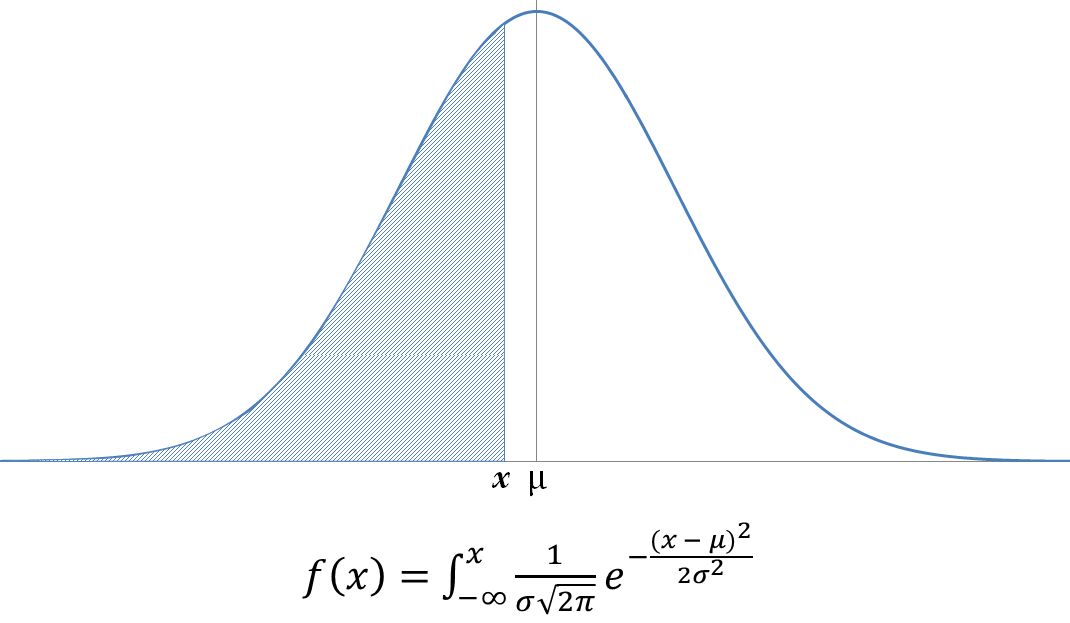
니미럴 인테그럴...
인터넷을 열심히 뒤지고 뒤져서 저 적분식이 있는지 (y = x 를 적분하면 y = 1/2 x2 + C 되는 식) 찾아봤으나 결론은 '그런 거 엄따.'
그렇다면...
내가 저 넓이를 근사치로라도 구하기 위해서 대충 7σ (표준편차의 7배로 이 정도면 확률밀도가 거의 0에 가깝기 때문에 굳이 마이너스 무한대로부터 시작할 필요는 없다.)정도에서부터 x 까지 값을 일일이 더하는 걸로 해볼까... 생각해서 아래와 같이 컴퓨터를 무지막지하게 고생하는 SQL을 한 번 만들어 봤다.
일단 앞에서 봤던, 누적(넓이)가 아닌 확률밀도 (선 높이)을 구하는 SQL을 다시 한 번 보자.
SELECT 1 /
          ( :stdv * SQRT( 2 * ACOS( -1 ) ) )
       *  EXP( - POWER( ( :InpVal - :mean ), 2 )
                 / ( 2 * POWER( :stdv, 2 ) )
             )
FROM DUAL
;
저 중에서 :InpVal 을 CONNECT BY LEVEL 의 값으로 대체하여 SUM 을 씌우도록 하자.
SELECT SUM(
           1 /
              ( :stdv * SQRT( 2 * ACOS( -1 ) ) )
           *  EXP( - POWER( ( (LEVEL / :DtlDgr + B.START_VALUE) - :mean ), 2 )
                     / ( 2 * POWER( :stdv, 2 ) )
                 )
          ) / :DtlDgr
FROM    DUAL
      , (SELECT   :mean
                  - SQRT(
                          -2
                        * POWER(:stdv, 2)
                        * LN(  :stdv
                             * SQRT(2 * ACOS(-1))
                             / POWER(10, 5)
                             * 5
                            )
                        ) AS START_VALUE
         FROM   DUAL
        ) B
CONNECT BY LEVEL <= (:InpVal - B.START_VALUE) * :DtlDgr
:InpVal 을 LEVEL / :DtlDgr + B.START_VALUE 로 대체 했는데, START_VALUE 라는 부분은 위에서 말한 7σ 정도로, 평균을 중심으로 확률밀도 (선의 높이)가 0에 매우 가까워지는 x 값을 말한다.
그냥 아래 그림의 맨 왼쪽에 X0 지점의 그래프 높이가 0에 가까운데, 저기를 START_VALUE 로 보면 된다. (위에서 POWER(10,5) 로 나누는 부분이, 값이 0에 가까운 10-5 정도면 0으로 본다는 뜻이다.)
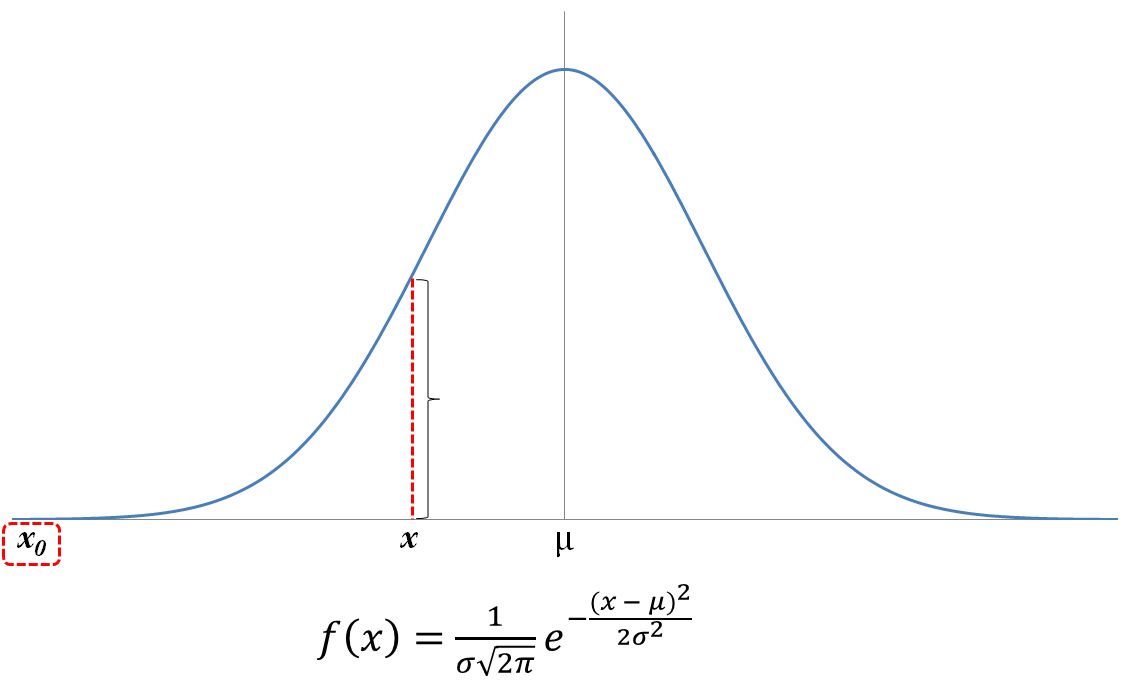
원래 – ∞ (무한대)부터 값을 더해 가야 하는데, 그건 불가능하니까 적당한 선에서(어차피 0에 매우 가까운 값이니 더해봐야 큰 차이 없는 거) 타협한 거. 결국 저 START_VALUE 에서 시작해서 오른쪽으로 높이들을 다 더해서 넓이를 구한다는 의미.
:DtlDgr 변수는 정밀도를 뜻하는데, 수치를 올릴수록 좀 더 잘 게 쪼개서 높이를 구하며 좀 더 근사치에 가깝게 한다. 하지만 수치가 늘어날수록 계산 속도가 엄청 늘어나게 되며, 심한 경우 몇 십 초씩 걸리게 되어서 실용적이지 못하다.
사실 이 방식으로는 소수점 3~4자리 정도까지의 정밀도밖에 보장하지 못한다. 더 높은 정밀도를 원하면 이후에 쓰여지는 글들을 보도록 하자.
여튼...
이 방식을 좀 더 속도를 빠르게, 그리고 그 덕분에 정밀도를 높일 여지가 있는 방식을 보자.
일반적인 누적 정규분포는 평균과 표준편차가 천차만별이고, 표준편차가 커질수록 계산해야 하는 X 값의 범위가 넓어져서 속도가 느려진다. 표준편차가 10인 거랑, 100인 거의 차이는 10배 가까이 나게 된다.
이때 앞에서 본 표준정규분포, 즉 평균은 0이고, 표준편차는 1인 걸 쓰게 되면 어떤 경우에도 X 값의 범위가 일정해져서 누적 분포를 구하기가 나아진다.
표준정규분포의 공식은 이전 글에서 나온 걸 다시 한 번 인용하는 걸로 한다.
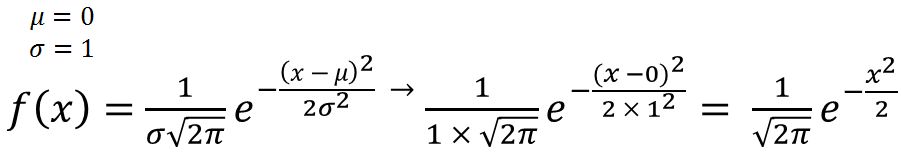
그리고 일반 정규분포를 표준정규분포로 변환시키는 공식은 아래와 같다. (μ 는 평균, σ 는 표준편차, x 는 입력값)
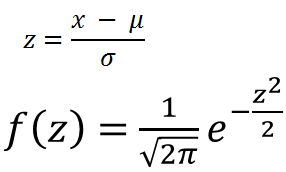
표준정규분포를 구현하는 SQL 역시 지난 글에서 봤던 SQL을 다시 확인한다.
SELECT 1 /
          ( SQRT( 2 * ACOS( -1 ) ) )
       *  EXP( - POWER( ( :InpVal ), 2 )
                 / ( 2 )
             )
       AS STD_RGL
FROM DUAL
;
여기에 똑같이 SUM 씌우고, :InpVal 을 CONNECT BY LEVEL 을 가공한 값으로 한다.
근데 :InpVal 이 평균(:mean) 일 경우 누적분포값이 0.5 이기 때문에, 아래 그림 부분의 넓이를 구한 후에 0.5에서 저 넓이를 빼거나 더하는 것으로 할 수 있다.
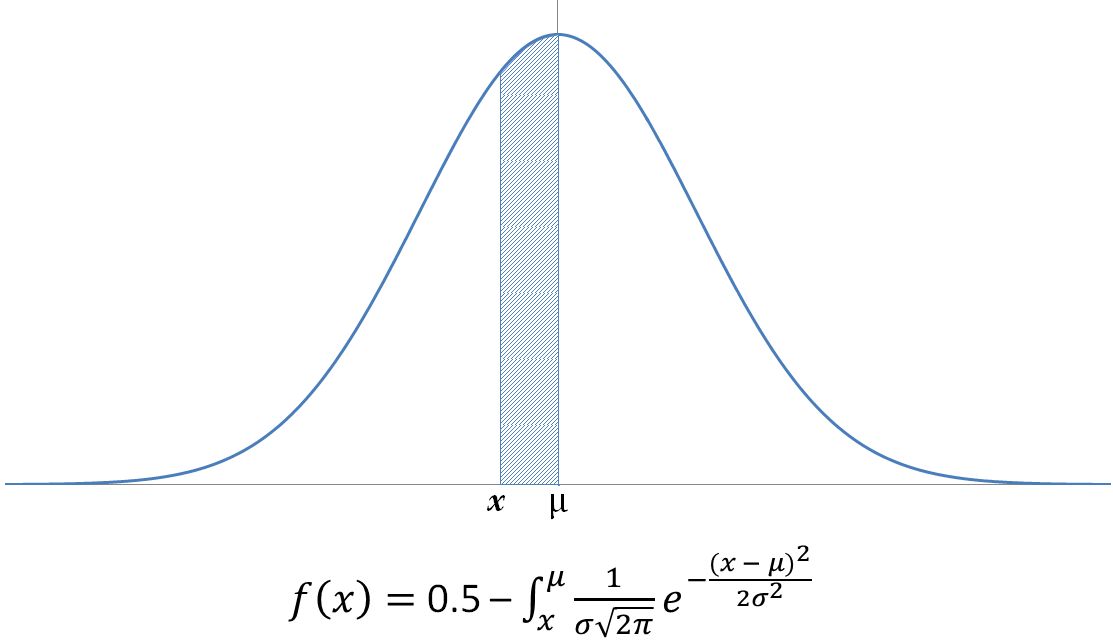

이 경우 넓이를 구해야 할 가로축의 수가 줄어들어서 속도 향상에 도움이 된다.(표준정규분포의 경우 x가 -7부터 1까지 넓이 구하기보다는 (–∞에서 0까지 면적인) 0.5 더하고, 나머지 0부터 1까지의 넓이를 구하는 게 계산을 덜 한다는 건 자명하다.)
SELECT   0.5
       +   SIGN(:InpVal - :mean) /* 평균보다 크면 +, 작으면 - */
         * SUM( 1 / (SQRT( 2 * ACOS(-1) ) )
                  * EXP( -POWER( X , 2) / 2 )
              )                 /* 표준정규분포 확률밀도 함수의 SUM */
         / (:DtlDgr + 1)
       AS REGULAR_DISTRIBUTE
FROM
    (
        SELECT  ( ( LEVEL - 1) / :DtlDgr ) AS X
        FROM    DUAL
        CONNECT BY LEVEL <=   ABS(:InpVal - :mean) / :stdv  /* 표준정규분포 변환식 z = (x - μ) / σ */
                            * :DtlDgr
                            + 1
    )
;
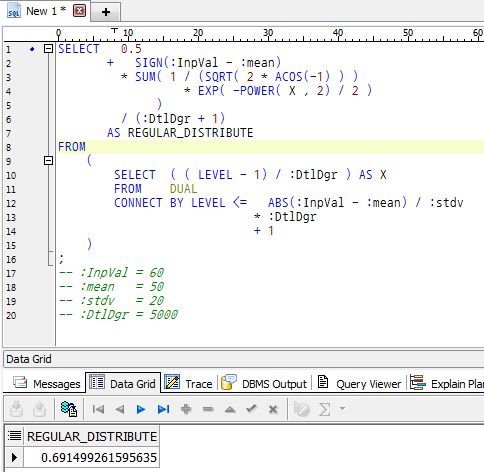
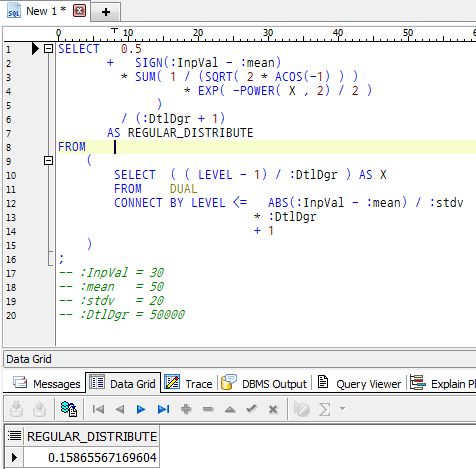
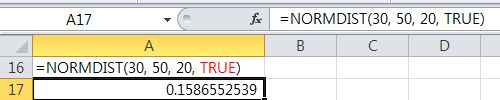
SQL을 돌린 결과와 EXCEL을 비교해보자.
엑셀에서 NORMDIST 를 사용하고, 누적여부를 TRUE 로 하면 된다.

소수 4째자리까지는 얼추 맞아졌다. 정밀도를 5,000에서 50,000 으로더 높이면 아래와 같이 나온다.
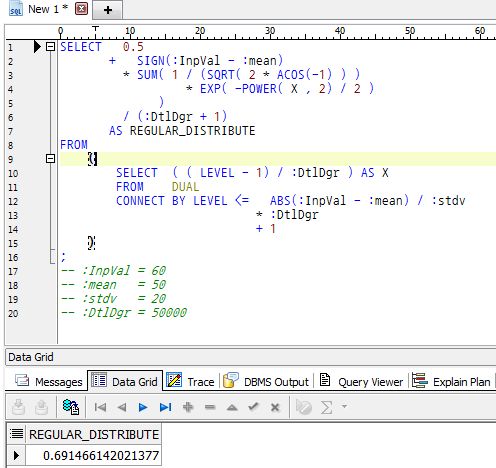
계산을 10배 더 하니 5째자리까지 비슷해졌다. 시간은 238 mSecs... 이거 한 건 조회할 때에는 몰라도 여러 건 조회할 때에는 분명 부담을 줄 거다.
마지막으로 평균보다 적은 케이스 하나만 더 올려서 얼추 맞다는 정도만 확인하자. (이번에는 525 mSec 걸렸다. 위험하다.)
엑셀은 아래와 같다.
자, 이렇게 할 수도 있으나 무식한 방법이라고만 알고 넘어가자.
- 누적 정규분포 확률.jpg [File Size:54.1KB/Download:311]
- 정규분포 확률 밀도.jpg [File Size:29.1KB/Download:294]
- 정규분포 확률밀도 0인 x 값.jpg [File Size:31.6KB/Download:230]
- 누적 정규분포 02.jpg [File Size:41.4KB/Download:216]
- 누적 정규분포 03.jpg [File Size:41.5KB/Download:201]
- 누적정규분포 확률 결과 01.jpg [File Size:44.3KB/Download:233]
- 누적정규분포 확률 결과 01 (엑셀).jpg [File Size:13.3KB/Download:236]
- 누적정규분포 확률 결과 01 (정밀도 향상).jpg [File Size:43.7KB/Download:230]
- 누적정규분포 확률 결과 02 (평균보다 작은 값 - 엑셀).jpg [File Size:13.1KB/Download:221]
- 누적정규분포 확률 결과 02 (평균보다 작은 값).jpg [File Size:43.9KB/Download:162]

이브리타, 나의 에뜨와르
너와 내가 공유하는 추억
너와 내가 만들 추억


